有道翻译OCR文字识别出错怎么处理?
发布时间:2026-10-17
有道翻译OCR文字识别出错时,可以先检查图片是否清晰、文字是否倾斜或被反光遮挡,再裁剪掉无关区域后重新识别。如果只是少量错字或漏字,可手动修改识别结果再翻译;若错误较多,建议重新拍摄清晰图片,并确认源语言设置正确,必要时改用文本输入方式完成翻译。
有道翻译OCR文字识别出错怎么处理
先检查原始图片是否适合OCR识别
- 提高图片清晰度:有道翻译官的拍照翻译会通过OCR识别图片中的文字,再进行翻译,因此原图是否清晰会直接影响后续结果。出现错字、漏字时,可以重新拍摄或换用分辨率更高的原图,尽量让文字边缘清楚,避免明显模糊、压缩和抖动。
- 减少画面中的无关内容:如果图片同时包含人物、图标、背景装饰和大量文字,OCR可能需要在复杂画面中判断文字区域。可以先裁剪图片,只保留需要翻译的段落,让文字尽可能占据更大的画面面积,再重新上传或拍照识别,通常更容易获得完整结果。
- 保持文字方向正常:图片中的文字如果倾斜、倒置或透视变形明显,识别难度会增加。拍摄文档、菜单或路牌时,可以尽量让镜头正对文字区域,使文字横平竖直。如果使用已有图片,也可以先旋转和裁正,再重新进行OCR识别。
根据识别结果重新处理文字
- 先检查识别文本再看译文:OCR出错后不要只看最终翻译结果,应先确认系统识别出来的原文是否正确。如果原文阶段已经出现错字、漏字或符号错误,后面的翻译自然也会受到影响。先纠正识别文本,再重新翻译,会比单纯反复切换翻译语言更有效。
- 少量错误可以手动修改:如果只是个别字母、数字或汉字识别错误,可以复制识别结果后手动修正,再放入普通文本翻译功能中重新翻译。有道翻译官本身同时提供OCR拍照翻译和文本翻译,因此可以把两种功能结合使用。
- 大量错误建议重新识别:如果整段文字都出现严重错位、乱码或缺失,不建议逐字修改。可以换一张更清楚的图片、缩小识别范围或重新拍摄后再处理。尤其面对密集表格、特殊字体或复杂排版时,重新准备图片通常比修正大量错误更省时间。
有道翻译OCR识别错误常见原因有哪些
图片质量问题容易影响识别结果
- 照片模糊会增加识别难度:手机拍摄时轻微抖动、没有对焦或图片经过多次压缩,都可能让文字笔画变得不清晰。OCR需要区分相似字符,因此“0”和“O”、“1”和“I”等字符在低清晰度图片中更容易被混淆,最终导致译文出现偏差。
- 光线太暗或反光会遮挡文字:拍摄书本、包装和菜单时,如果环境光线不足,文字区域可能出现噪点;如果纸张或屏幕产生反光,又可能覆盖部分笔画。建议调整拍摄位置,使文字亮度均匀,同时避免灯光直接反射到需要识别的区域。
- 文字尺寸过小也会影响效果:一张图片包含整页密集内容时,每个字符实际占用的像素可能很少,即使肉眼能够看清,OCR也可能识别不完整。可以把页面分成几个区域分别拍摄或裁剪,放大重点段落后再进行文字识别。
文字内容本身也可能增加识别难度
- 特殊字体容易产生错字:艺术字体、手写体、连笔字以及经过特殊设计的标题,比常规印刷字体更难识别。遇到这类内容,可以寻找同一文字的标准字体版本,或者手动输入关键内容后使用有道翻译的普通文本翻译功能。
- 复杂排版可能打乱阅读顺序:双栏文章、表格、海报和图文混排内容并不是简单从上到下排列,OCR可能把不同区域的文字连接在一起。此时可以分区域截图,每次只识别一个段落或表格单元,减少版式结构对识别顺序的干扰。
- 混合语种会增加判断难度:同一图片如果同时出现中文、英文、日文、数字和特殊符号,系统需要识别不同字符类型。有道的图片翻译服务支持包括中文、英文、日文、韩文、法文等多种语言,但复杂的多语种混排仍可能增加识别难度。
有道翻译OCR识别错字漏字怎么修正
先修正可以直接编辑的识别结果
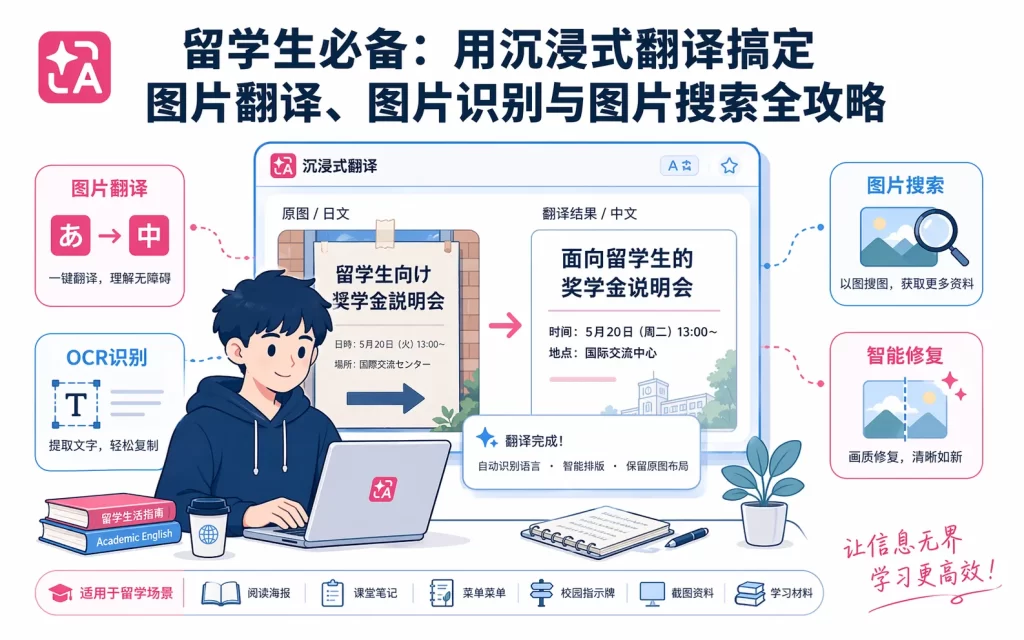
- 找到错误字符逐个修改:OCR完成后,如果当前页面允许复制或编辑识别文字,可以先与原图逐行比较,把明显错误的汉字、字母、数字和标点修正。修改原文后再进行翻译,可以避免一个错误字符继续影响整个句子的理解。
- 重点核对数字和专有名词:人名、地名、型号、日期、价格和编号对字符准确度要求较高,一旦识别错误可能改变实际含义。处理合同、说明书或旅行信息时,应特别核对这些内容,不要因为整句看起来通顺就忽略其中的数字错误。
- 无法编辑可以复制到文本翻译:如果OCR结果页面没有方便的直接修改入口,可以复制能够识别出的文字,粘贴到有道翻译的文本输入框中,再手动补充漏掉的字符后重新翻译。有道翻译目前同时支持图片和文本翻译,因此这种方式适合处理少量识别错误。
漏字较多时重新进行OCR识别
- 缩小每次识别的文字范围:一张图片内容过多时,可以把原图裁成几个小区域,每次只识别一段文字。这样可以减少无关图片、标题和装饰元素对OCR的干扰,也方便用户逐段核对识别结果是否完整。
- 放大文字后重新截图:对于网页、PDF或电子文档,可以先把页面放大,再截取需要识别的区域。桌面端有道翻译目前提供截屏翻译、划词翻译和图片翻译等功能,因此电子内容不一定必须使用手机重新拍摄。
- 严重漏字时换用原始文件:如果图片来源本身就是PDF、Word或网页截图,而文字可以直接选择复制,优先使用原始文本往往比OCR更稳定。OCR更适合处理不能直接复制的图片文字,不必对所有电子文档都强制使用图片识别。
有道翻译OCR识别图片模糊怎么办
重新拍摄一张更清晰的图片
- 先擦拭镜头并重新对焦:手机镜头表面有指纹或灰尘时,照片可能看起来像蒙了一层雾。重新拍摄前可以清洁镜头,并点击屏幕中的文字区域完成对焦,确认文字边缘清楚后再拍照,这比后期反复锐化模糊图片更有效。
- 增加环境光线但避免反光:在光线不足的环境中,可以移动到更明亮的位置拍摄,但不要让强光直接照在光滑纸张或屏幕上。理想状态是文字区域整体亮度均匀,没有明显阴影、过曝或反光遮挡。
- 保持手机稳定再按下快门:拍摄过程中手部晃动会产生运动模糊,尤其是在室内弱光条件下更加明显。可以用双手固定手机,靠近桌面或墙面保持稳定,并让摄像头与文字区域保持平行,再进行拍摄识别。
已有模糊图片可以尝试重新处理
- 先裁剪掉无关区域:如果无法重新获得原图,可以先把图片中没有文字的边缘、背景和装饰部分裁掉,使需要识别的文字占据更大画面。OCR处理更集中的文字区域时,通常比直接识别整张复杂图片更容易。
- 尝试使用更高质量原图:聊天软件转发、网页缩略图或社交平台保存的图片可能经过压缩。如果有原始照片或原始截图,应优先使用原文件。图片尺寸更大、压缩更少,可以为OCR提供更多字符细节。
- 无法辨认时改用人工输入:如果图片已经严重失焦,即使放大后肉眼都无法准确辨认文字,继续重复OCR通常意义不大。可以根据能够辨认的内容手动输入,或寻找同一文档的清晰版本,再使用普通文本翻译完成后续处理。
有道翻译OCR识别语言错误怎么调整
先确认图片中的实际语言
- 正确判断原文语种:进行图片翻译前,应先确认文字到底属于英语、日语、韩语、法语还是其他语言。有道翻译官的整体翻译能力覆盖多种语言,同时提供OCR拍照翻译,因此正确选择或识别原文语言有助于后续翻译流程。
- 注意外形相似的文字:中文与日文汉字之间存在大量相同或相似字符,如果图片只有几个汉字,自动识别可能缺乏足够上下文。遇到这种情况,可以手动选择正确的源语言,并尽量让图片包含完整词组或句子,增加语言判断依据。
- 混合语言建议分区域处理:一张菜单、说明书或网页截图可能同时出现中文、英文和其他语言。此时可以分别裁剪不同语种区域,再单独进行识别和翻译,避免系统在同一区域中同时判断多套文字体系。
检查源语言和目标语言设置
- 重新设置源语言:如果OCR把日文当成中文、韩文当成其他语言,可以返回语言选择区域,查看当前版本是否允许手动指定源语言。设置正确后重新上传原图,有时可以改善后续识别和翻译结果。
- 确认目标语言没有选错:有些情况下OCR识别出的原文其实正确,只是目标语言设置与预期不同,导致用户误认为文字识别错误。应分别检查“识别出来的原文”和“最终译文”,先判断问题究竟发生在OCR阶段还是翻译阶段。
- 仍然错误可以改用文本模式:如果图片中只有少量文字,而且自动识别语言持续判断错误,可以手动输入或复制正确原文到文本翻译页面,再明确选择源语言和目标语言进行翻译。这样能够绕过OCR环节,直接检查翻译功能是否正常。
有道翻译OCR文字识别一直出错怎么办
排除图片和客户端本身的问题
- 换一张简单图片进行测试:如果同一张图片反复识别失败,可以先用白底黑字、字体清楚的简单截图测试。有道翻译官官方说明明确支持OCR摄像头取词和拍照翻译,如果简单图片正常,而原来的图片持续错误,问题通常更可能出在图片质量或版式上。
- 重新启动客户端再识别:当多张正常图片都突然无法识别时,可以完全关闭有道翻译后重新打开,再进行一次测试。电脑端也可以重新启动程序,避免临时缓存、页面加载或程序状态异常影响OCR功能。
- 更新后再次进行测试:有道翻译桌面端仍在持续更新,官方历史更新记录也曾提到OCR取词能力的增强,因此如果长期使用较旧版本,可以检查是否存在可用更新,再重新测试图片识别功能。
根据具体内容更换处理方式
- 电子文档优先使用文档功能:如果需要识别的是PDF、Word、PPT等电子文件,不一定需要先截图再OCR。当前有道翻译桌面端本身提供文档翻译、图片翻译、截屏翻译等多种方式,可以根据原始资料类型选择更直接的处理方式。
- 少量文字直接输入更快捷:只有一两行内容却反复OCR失败时,直接手动输入通常比不断拍照、裁剪和重新识别更高效。尤其是验证码式短字符、特殊符号和型号代码,本身就不是OCR最适合的处理对象。
- 重要内容一定进行人工核对:无论OCR最终识别效果多好,都不建议把识别结果视为百分之百正确。处理合同、证件、医疗说明、金额、地址或专业资料时,应将识别文字与原图逐项核对,再检查最终译文,避免错字和漏字影响实际理解。
常见问题FAQ
有道翻译OCR为什么会出现错字或漏字?
常见原因包括图片模糊、文字过小、拍摄倾斜、光线不足、反光遮挡以及字体过于特殊等。遇到这类情况,可以重新拍摄清晰图片,尽量让文字保持水平并占据主要画面,再裁剪掉无关背景后重新识别,通常能减少错字和漏字。
有道翻译OCR识别图片一直失败怎么办?
如果多次识别都失败,可以先换一张白底黑字、内容简单的图片测试,判断是否是原图质量问题。同时检查网络状态、应用权限和客户端运行是否正常。若简单图片也无法识别,可以重启或更新有道翻译,再重新尝试OCR功能。
有道翻译OCR识别出来的文字可以修改吗?
如果识别结果支持编辑,可以直接把错误的文字、数字或标点修改正确后再进行翻译。如果当前页面不能直接编辑,可以复制识别出来的文字到普通文本翻译区域,手动补全漏字或修正错字,再重新翻译,这样能够避免错误原文继续影响译文。
有道翻译OCR识别语言错误怎么解决?
先确认图片中的真实语种,再检查有道翻译当前选择的源语言是否正确。如果图片同时包含中文、英文、日文等多种语言,可以将不同语种区域分别裁剪后识别。自动识别仍然出错时,建议手动指定源语言,再重新上传图片进行文字识别。